五层节流栈:爬虫后台修复指南
【这是什么】
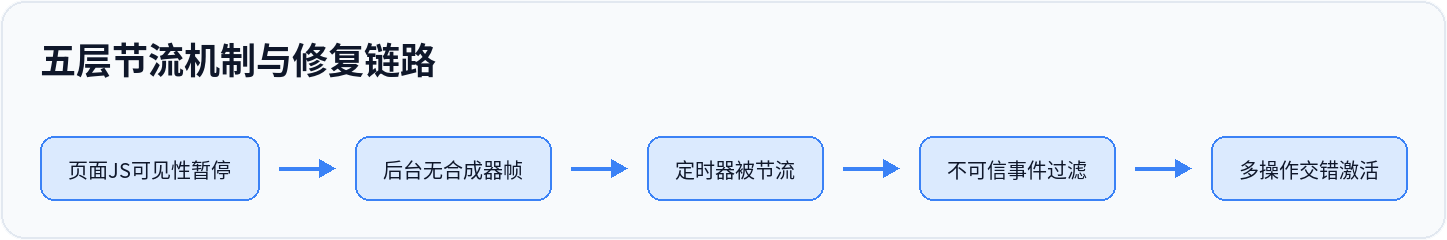
Scrapewright 是一个面向爬虫工程师的开源工具/库,专门解决“Chrome 后台标签页对爬虫工作静默节流”这一系统性难题。它首次把后台标签页的节流机制拆分为五个相互独立又层层叠加的层级,并为每一层提供了可落地的修复方案:
- 第 1 层:页面自身 JS 通过
document.visibilityState/document.hidden暂停无限滚动。修复方法是在 MAIN 主世界注入脚本,覆盖可见性属性,并配合requestAnimationFrame保活循环。 - 第 2 层:Chrome 不为后台标签页生成合成器帧,导致
IntersectionObserver回调永不触发,懒加载失效。修复方法只有一个:让爬虫标签页真正成为活动标签页。Scrapewright 实现了“粘性激活”——在连续操作间保持标签页激活,并在爬虫标签页关闭时恢复用户最后点击的标签页。 - 第 3 层:后台定时器被节流,Windows 上还有遮挡计算(
CalculateNativeWinOcclusion)导致的渲染器后台化。修复方法是通过 CLI(scrapewright throttle on)重写 Chrome 启动器,加上--disable-background-timer-throttling、--disable-backgrounding-occluded-windows、--disable-renderer-backgrounding等标志。但作者明确强调,仅靠标志无法修复第 2 层。 - 第 4 层:页面过滤不可信输入事件,程序化
scrollBy永远不会被event.isTrusted通过。修复方法是通过chrome.debugger发出 CDPInput.dispatchMouseEvent滚轮事件,让事件进入真实输入管道,以isTrusted: true到达页面。 - 第 5 层:多个操作交错时(悬停、子标签页加载、详情页渲染),每个操作都独立地要求活动标签页。修复方法是把激活能力做成基础设施,所有涉及帧或输入的路径复用同一套激活请求。
项目还自带白皮书,其中 §9 用失败故事解析每一层。核心代码位于 lib/visibility-keepalive.js、lib/tab-activation.js、lib/scroll-ops.js。仓库地址为 github.com/singhand-labs/scrapewright,采用 GPLv3 许可。
【背景 / 谁做的】
仓库由 singhand-labs 发布,从帖子行文和技术深度看,作者是长期与 Chrome 内部机制打交道的爬虫技术专家。项目代码命名清晰,lib/tab-activation.js 被描述为“仓库中最为谨慎的代码之一”,说明作者对浏览器标签页激活、MV3 service-worker 暂停、窗口焦点等细节有深入理解。这不是一个营销驱动的项目,而是一个实打实的工程知识产品:既有可复用的代码库,又有体系化的白皮书教育材料。
从商业模式推测,该项目目前更像是一个“技术权威建立”型开源项目:通过暴露一个普通爬虫工程师很难发现的底层问题,并给出完整分类和解决方案,来建立项目在爬虫领域的话语权。GPLv3 许可下,代码本身不直接销售,但白皮书、企业支持、增值服务都可能成为后续变现路径。
【怎么获客】
Scrapewright 的获客策略非常典型:用深度技术内容做冷启动。
- 帖子内容本身是高密度技术分析,标题“极客五层节流栈”直接吸引遇到“后台抓取不足”问题的开发者。
- 以 Hacker News 为主要发布渠道,目标用户是 HN 上的技术社区核心人群,这些人群又恰好是爬虫工具的重度使用者。
- 白皮书和仓库代码作为“吸铁石”,用户遇到问题后搜索“Chrome 后台标签页爬虫”这类关键词,就有可能进入项目文档。
- CLI 工具
scrapewright throttle on提供了一个低门槛的即时价值:用户不需要理解五层机制,只需跑一条命令就能为 Chrome 添加正确的启动标志。 - 帖子中特意标注“这是免费教育材料”,降低分享门槛,促进二次传播。
目前公开信息中看不到付费投放或销售团队痕迹,完全是内容驱动的获客模型。对一人公司来说,这种模式成本极低,但需要足够的技术权威支撑。
【验证情况 / MRR】
帖子没有提供任何形式的 MRR、GitHub Star 数、下载量或付费用户数据。可以确认的“验证”包括:
- 帖子所描述的问题在爬虫社区中是真实且普遍的——几乎所有爬虫工程师最终都会遇到“后台标签页抓取不足”的 bug。
- 作者声称 Scrapewright 是“这些层最完整的开源分类”,但没有附带第三方评价或数据佐证。
- 仓库以 GPLv3 开源,代码本身免费,因此短期内不是收入来源。
从项目阶段看,它处于“技术验证 + 社区验证”阶段,尚未形成明确的收入闭环。如果未来要商业化,可能的路径包括:提供企业级支持、维护服务、或者基于该技术栈推出云服务。但目前这些都没有公开信号。
【对一人公司的可复制性】
这个项目对一人公司有很强的参考价值,尤其在如何把隐性工程知识变成可传播资产这一点上:
- 选择极度垂直的痛点:不是泛泛的“爬虫工具”,而是“Chrome 后台标签页节流”这一具体细分问题。解决这个问题需要深入浏览器内部,竞争者少,一旦解决就有壁垒。
- 把问题拆成体系:五层分类本身就是一种知识产品。即便用户不下载代码,光看这篇帖子就获得了价值。这种“先教育、后引流”的方式,非常适合一人公司的内容营销。
- 开源核心 + 白皮书深度内容:代码库解决了“怎么做”,白皮书解释了“为什么”,两者结合形成完整的产品体验。用户信任度远高于普通开源项目。
- 利用 GPLv3 的杠杆:授权许可从法律层面阻止大公司直接闭源使用,为一众小团队创造公平竞争环境。虽然 GPL 可能吓退部分商用用户,但在开发者社区反而容易获得好感。
- 文档/代码目录结构本身就是卖点:
lib/tab-activation.js、lib/visibility-keepalive.js这种命名清晰的文件,说明作者把代码也当作产品的一部分来设计。
一人公司完全可以照搬这个模式:选一个自己每天都会踩的坑,深挖到底层原因,做成开源工具 + 体系化工商业科普,再用 HN 等社区发起传播。短期内不为赚钱,长期靠权威和信任衍生商业机会。
【风险与机会】
风险:
- Chrome 自身演进风险:后台标签页节流机制是 Chrome 架构的一部分,并非公开 API。Chrome 未来可能修改合成器帧策略、调整启动标志的行为,甚至移除某些 flag。Scrapewright 的代码和文档需要持续跟进 Chrome 改动,否则很容易失效。
- CDP 依赖风险:第 4 层依赖
chrome.debugger和Input.dispatchMouseEvent。CDP 是相对稳定的接口,但仍是内部实现的一部分,存在变更风险。 - GPLv3 授权限制:GPLv3 具有强 copyleft 属性,任何发行衍生代码的使用者都必须以 GPLv3 授权。这会让一些潜在企业合作伙伴(尤其是闭源产品)选择放弃集成,只用到白皮书或概念。
- 目标市场规模有限:“后台标签页节流”虽然痛点真实,但只影响一小部分爬虫工程师、自动化测试人员和浏览器自动化开发者。如果只做工具,天花板清晰。
- 维护成本高:解决五层问题涉及启动标志重写、MV3 service-worker 暂停处理、窗口焦点管理等多个复杂子系统,一人公司需要持续投入才能保持质量。
机会:
- AI 训练数据抓取需求暴增:大模型公司需要大规模抓取网页数据,后台并行抓取对稳定性要求极高。Scrapewright 能解决一个很实际的“抓取到一半就停”的问题,直接推动 AI 数据管道效率。
- 从“工具”到“基础设施”的升级:5 层分类模式可以被抽象为更通用的“浏览器后台保活”服务,服务对象不仅是爬虫,还包括端到端测试、定时监控、数据看板等场景。
- 付费白皮书/企业培训:白皮书已经成型,§9 还有失败故事,这是极好的教材。可以面向爬虫团队、内部工具开发者做付费课程或企业内训。
- 云服务形态:把 Scrapewright 打包成云端浏览器服务,用户通过 API 提交任务,服务端自动处理所有节流层,按调用量收费。这样跳过了用户自己管理 Chrome 的复杂性,完全变成商业产品。
- 品牌效应:如果项目持续更新并保持正确性,
singhand-labs可以成为爬虫领域的技术权威,后续再推其他工具时获客成本将大幅降低。
信息来源:Hacker News、GitHub
- 第一步:在主世界(MAIN world)注入脚本,覆盖 document.visibilityState / document.hidden,并配 requestAnimationFrame 保活循环,解决页面自身 JS 暂停无限滚动(对应 lib/visibility-keepalive.js)。
- 第二步:用 chrome.debugger 发出 CDP Input.dispatchMouseEvent 滚轮事件替代程序化 scrollBy,让事件以 isTrusted: true 进入真实输入管道(对应 lib/scroll-ops.js)。
- 第三步:写一个 CLI(如 scrapewright throttle on)重写 Chrome 启动器,加上 --disable-background-timer-throttling、--disable-backgrounding-occluded-windows、--disable-renderer-backgrounding 等标志,先给用户一条命令的即时价值,但要说明这解决不了第 2 层。
- 第四步:把标签页激活做成基础设施(lib/tab-activation.js),实现「粘性激活」:连续操作间保持标签页激活,爬虫标签页关闭时恢复用户最后点击的标签页,供所有涉及帧或输入的路径复用。
- Chrome 架构演进风险:后台节流是 Chrome 内部实现而非公开 API,未来可能改合成器帧策略、调整或移除启动 flag,代码与文档需持续跟进否则失效。
- GPLv3 强 copyleft:任何发行衍生代码者都须以 GPLv3 授权,闭源企业产品可能直接放弃集成,只能消费白皮书/概念,商业转化受限。
- 维护成本高:五层修复涉及启动标志重写、MV3 service-worker 暂停处理、窗口焦点管理等多个子系统,一人公司需长期投入才能保持正确性。
- 目标市场天花板清晰:只影响一部分爬虫工程师、自动化测试与浏览器自动化开发者,且项目没有公开的 Star/下载/付费数据支撑验证。