一人练不了的口语,AI双角色德语B1陪练
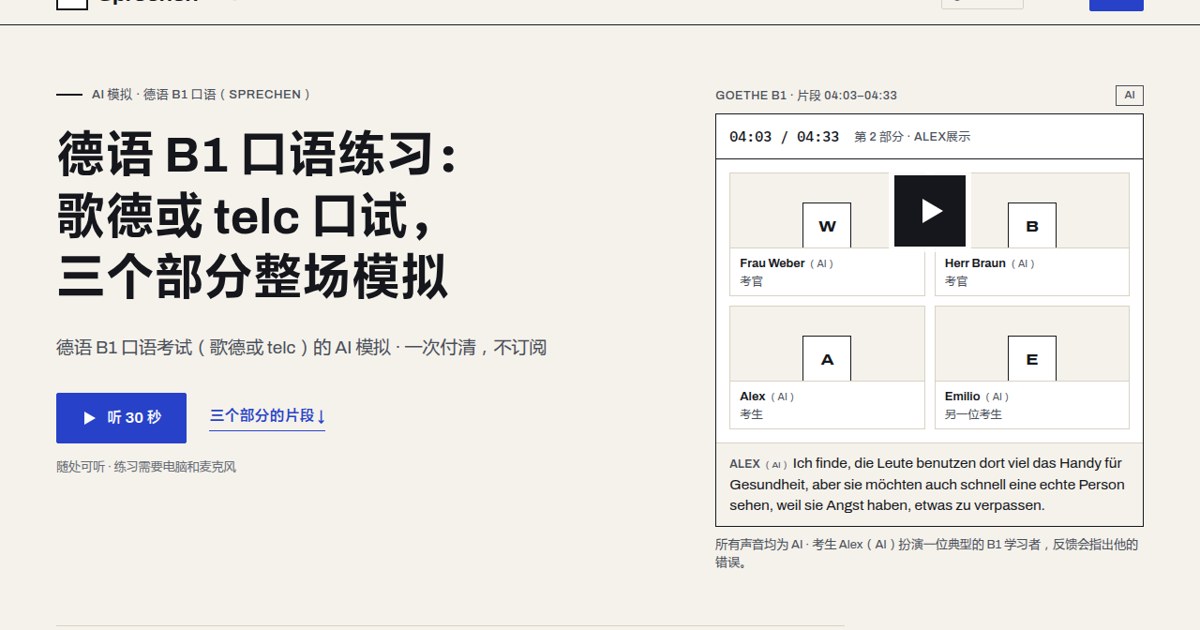
德语 B1 口语考试陪练工具 b1sprechen.com 拆解
【这是什么】
b1sprechen.com 是一个针对德语 B1 口语考试的 AI 模拟陪练工具,瞄准的是报考 Goethe(歌德)或 telc B1 证书的考生。
产品形态很明确:一场完整的口试模拟,AI 扮演两个角色——考官和另一位考生。这解决了自学口语最大的结构性难题:口语是双人任务,一个人练不了。歌德 B1 口试由三个部分组成(共同计划一件事、主题报告、对他人报告给出反馈并提问),全程约 15 分钟,两名考生同场。真实的考试压力来自"被追问"和"被打断",而不是单向朗读。
技术上是两条链路:
- 实时对话走 GPT-Live,做低延迟语音交互,模拟考官的即时追问
- 复盘反馈走 GPT-6,输入是"你说过的句子",输出是逐句点评
- 录音回听保留,让考生能自己听发音、语速、卡顿位置
作者在帖子里明确建议用电脑加麦克风,说明移动端体验还不是主路径。
【背景 / 谁做的】
发布渠道是 V2EX,给出的免费体验码是 V2EX-9MFP。这是典型的个人开发者发帖:中文技术社区、专属码、末尾一句"想听听考过的朋友觉得这和真实考试有什么差距"——这句话暴露了作者的身份定位:他大概率是德语学习者本人或身边有备考者,而不是教育行业的从业团队。
判断依据有三点:
- 单一 SKU。只做 B1、只做口语、只做德语一个语向。产品线没有横向铺开,说明是先用最小成本验证一个考试+一个技能点。
- 域名即关键词。b1sprechen.com(Sprechen 是德语"说")——这个命名方式不是市场团队的做法,是做 SEO 长尾流量的人的做法。
- 没有公开任何仓库、公司实体或团队信息。整条帖子只有产品链接、体验码和一句求反馈。
对比同批出现的 Show HN 项目——比如做 BBC 新闻实时分级简化(A2/B1/B2)的那个——可以看到"CEFR 分级 + 实时 AI"这条线上同时有多人在探索不同切面。b1sprechen 切的不是"泛语言输入",而是"考试场景的输出"。
【怎么获客】
获客路径清晰且成本极低:
第一步,社区冷启动。 V2EX 帖子 + 专属体验码。体验码这个动作同时干了两件事:降低试用门槛,以及精确统计这次发帖带来了多少人、多少人真的用了。V2EX-9MFP 就是一个可归因的渠道探针。
第二步,搜索长尾。 这是这类产品的命脉。"德语 B1 口语怎么练"、"歌德 B1 Sprechen 模板"、"telc B1 口试"、"B1 mündliche Prüfung üben" 这类词,搜索量不大但意图极度明确、转化率极高,而且几乎没有像样的商业内容在竞争。b1sprechen.com 这个域名本身就是在往这个池子里下钩。
第三步,备考社群的口碑扩散。 德语考生的聚集地是高度集中的:小红书德语学习话题、豆瓣德语小组、Reddit 的 r/German 与 r/GoetheInstitut、各类 Discord 备考群、以及国内留学中介的学员群。这个人群的关键特征是有明确考试日期——备考周期通常只有 4 到 8 周,所以决策快、付费窗口短、用完即走,但也意味着每年有稳定的新考生补充进来。
要注意的转化漏斗细节: 免费体验码用完之后怎么续?产品里有没有"考试倒计时"这类制造紧迫感的钩子?作者帖子末尾那句求反馈,本身就是一份需求调研——他要知道"AI 模拟和真实考试的差距在哪",那正是下一版产品要补的地方。
【验证情况 / MRR】
没有公开的收入数据、用户量、留存率或 MRR。 帖子本身只提了免费体验码,没有提定价、没有提付费转化,也没有提任何使用量。
可以确认的验证信号只有两条,一强一弱:
- 强信号:产品已经上线可访问,实时语音 + 逐句反馈 + 录音回听三条链路都做完了,不是 demo 落地页。
- 弱信号:作者主动到中文社区发码求反馈,说明还处在找早期用户的阶段,而非已经有稳定自然流量。
对这类产品,真正该盯的指标不是注册数,而是这几个:
- 体验码核销率——发出去多少,真的用了多少
- 三部分走完率——中途退出发生在第几部分,直接反映语音延迟和打断体验
- 复盘页打开率与录音回听率——如果用户不看反馈,那 GPT-6 那条链路就是纯成本
- 第二次使用间隔——口语备考需要高频重复,次日/次周回访是核心健康度指标
【对一人公司的可复制性】
可复制性:高。 这是典型的"一人 + 一套 API + 一个垂直场景"的结构。
技术难度集中在三个点,都不算深:
- 实时语音会话的双角色编排(考官 + 同考考生,涉及发言权切换和打断处理)
- 把考试结构沉淀成结构化的 prompt 脚本:三个部分的时长分配、考官在每个部分的提问逻辑、什么时候该追问
- 录音存储 + 会话转写 + 逐句点评的异步处理
真正难的不是代码,是考试结构的知识。 你得知道歌德 B1 和 telc B1 的口试差别在哪、每部分考官会问什么、评分看哪几个维度、常见话题池有哪些。这部分内容在网上是零散的、德语的、藏在论坛和 PDF 里的。谁能把它结构化成机器可执行的脚本,谁就有护城河——而这个护城河是可以横向迁移的。
可复制的扩张路径很清晰: 把"一场考试"抽象成模板(考试局 × 级别 × 技能),然后复制 SKU——A1/A2/B2/C1、telc/DSH/TestDaF、听力/写作。同一套引擎,边际成本接近零。这是这个产品结构最值钱的地方,也是作者目前还没有做的地方。
成本结构要盯死: 实时语音 API 按分钟计费,一次完整模拟 15 分钟,加上双角色对话,是产品的主要边际成本。优化方向很明确——实时环节用最便宜的方案,复盘环节异步跑,因为复盘不需要实时性,用户完全可以等 30 秒拿一份逐句报告。把贵的算力放在用户能感知价值的地方。
定价锚点: 参照物是真人外教一对一口语练习(一节课的价格)和线下备考班。AI 陪练的合理区间是真人价格的零头,且必须提供"无限次练"的心理价值——因为口语提升靠的是重复次数,不是单次质量。
【风险与机会】
风险:
- 平台依赖是最致命的。 产品价值的一半绑在 GPT-Live 的延迟和价格上,另一半绑在 GPT-6 的点评质量上。任何一次模型涨价、接口变更或地区限制,都会直接冲击毛利和可用性。
- 官方模型自带语音模式就是最大竞品。 用户完全可以直接开一个语音对话,让它扮演考官。要让人愿意付费,必须在"通用语音助手做不到的地方"建立壁垒——逐句纠错、考试结构、评分维度、录音回听,这四件事里任何一件被通用助手顺手做了,付费理由就被削弱。
- 商标与考试结构的合规问题。 使用 Goethe 或 telc 的名义做宣传存在商标风险,尤其是这些机构对考官资质和官方模拟材料有严格控制。稳妥做法是描述考试结构而不冒用机构名。
- 点评出错会直接摧毁信任。 如果系统把说对的句子标成错的,备考者会立刻失去信任——这个人群对准确性极度敏感,因为他们正在为一场决定签证或入学的考试做准备。
- 语音识别的德语口音鲁棒性。 亚洲学习者的德语发音是 ASR 的难点,识别错误会级联到点评错误。
机会:
- 逐句反馈是真正的差异化。 通用语音助手能陪你聊,但不会给你一份"你这句的语序错了、这个动词位置不对"的清单。这是这个产品最应该被放大宣传的点。
- 押题与话题库。 口语考试的话题池是有限的、可枚举的。把高频话题做成结构化练习——今天是"环保",明天是"居家办公"——用户会为了覆盖率付费。
- 中文母语者的专属痛点。 语序、冠词、动词位置、长短音,这些是中文学德语者系统性的错误模式。针对性地做纠错规则,比通用模型更准,也是本地化壁垒。
- 备考周期短反而是优势。 4 到 8 周的窗口期意味着用户付费意愿集中、转化路径短,不需要长期留存设计,只要在窗口期内提供足够多的练习次数。
- B2B 出口。 语言学校、留学中介、企业外派培训都需要低成本的开口机会,一人公司做不了大客户,但可以做小机构的标准工具包。
- 同期出现的"AI 考试诚信系统"那条帖子提示了另一个方向:考试机构本身对 AI 既警惕又需要,未来"官方认可的模拟工具"可能是一个位置。
信息来源:V2EX、Hacker News(Show HN)
- 第一步:用 GPT-Live 搭实时语音会话,让 AI 分饰考官与同考考生两个角色,处理发言权切换与打断
- 第二步:把歌德/telc B1 口试三部分结构写成结构化 prompt 脚本(时长分配、提问逻辑、追问时机)
- 第三步:用 GPT-6 异步跑录音转写与逐句点评,附录音回听页,不占用实时算力
- 第四步:以关键词域名 + V2EX 专属体验码冷启动,用核销率验证需求再谈定价
- 半数价值绑在 GPT-Live 延迟与价格上,模型涨价或接口变更直接冲击毛利
- 官方语音助手自带模式即最大竞品,逐句纠错/考试结构不做深就沒有付费理由
- 以 Goethe、telc 名义宣传存在商标与合规风险,机构对模拟材料控制严格
- 德语发音的 ASR 鲁棒性差,识别错误会级联成错误点评,一次误判即失去信任