一个人囤了56亿条TikTok数据
TikTok 5.6B 视频元数据开放:一份单人维护的数据资产拆解
【这是什么】
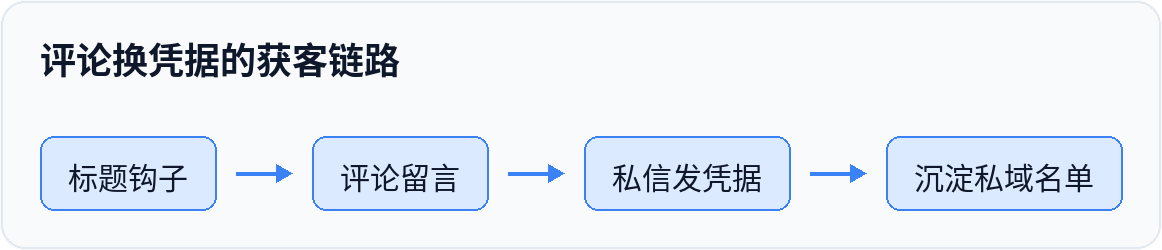
一条把「数据囤积」直接变现为注意力的帖子:作者把 56亿条 TikTok 视频元数据上传到 Hugging Face(数据集路径 datasocial/tiktok-5.6B-videos),同时自托管一套 ClickHouse,允许外部用户直接写 SQL 查询,凭据通过评论区留言私信发放。
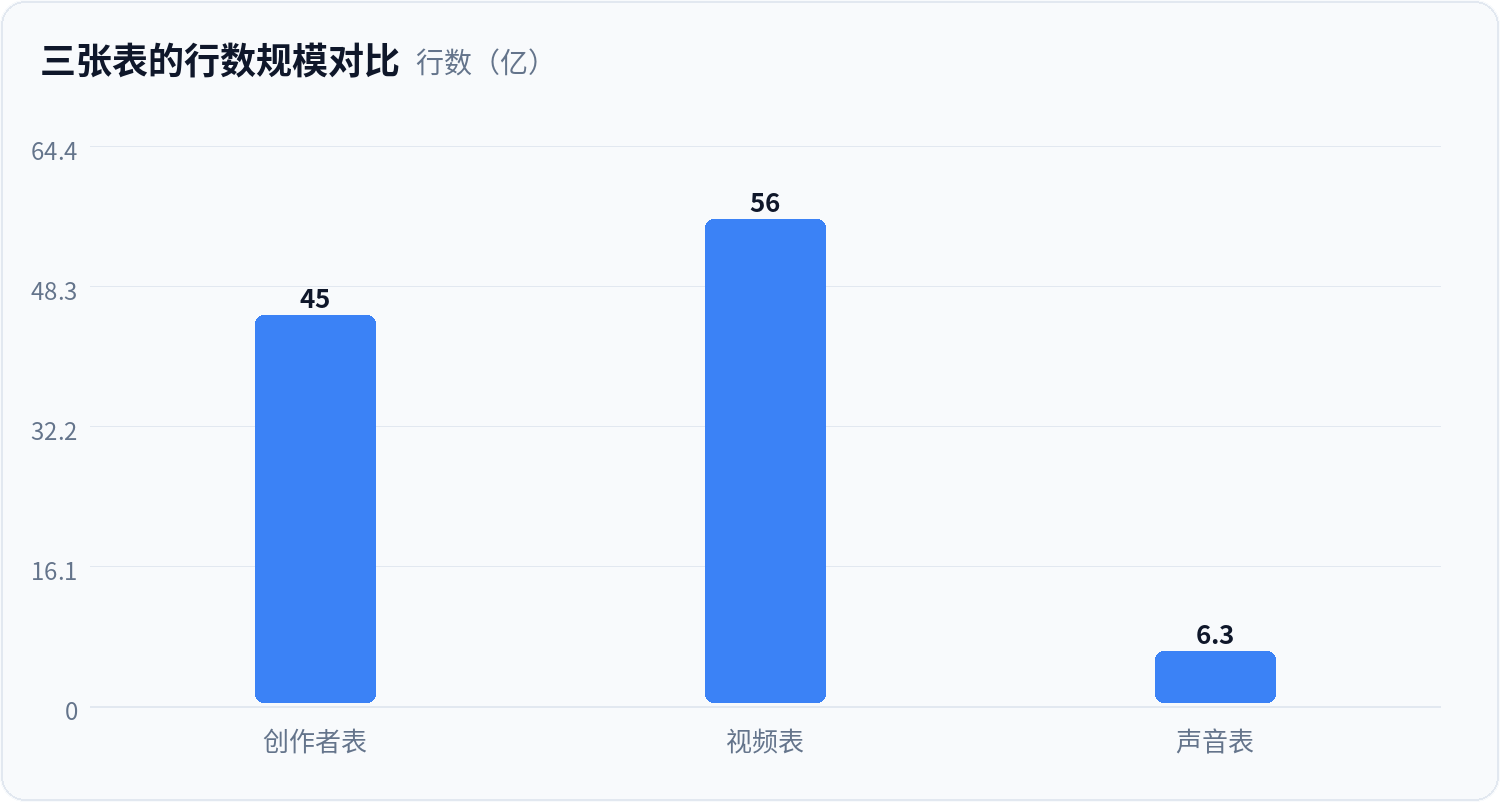
数据库里有三张表:
- 创作者表:45亿行
- 视频表:56亿行
- 声音表:6.33亿行
关键在「元数据」三个字。数据里没有视频文件、没有字幕、没有评论正文,只有可结构化分析的部分:谁发的、什么时候发的、用了哪段声音、传播表现的骨架。这让它的用途偏向趋势分析、声音(BGM)流行度追踪、创作者活跃度与内容图谱,而不是内容语义理解。
产品形态上,它其实做了两件事:一个静态公开数据集,一个带 SQL 接口的在线查询服务。前者是资产,后者是体验——作者明确意识到「下载数十亿行」是最大的使用门槛,所以把「能查」当成了卖点。
【背景 / 谁做的】
发帖人 /u/DataShack,从命名和发布社区看,属于典型的数据囤积/数据工程玩家,而不是产品团队。这从两个细节能读出来:数据库是自托管的,不在云上;帖子里直接请求「不要运行繁重的查询导致我的服务器崩溃」——这句话既说明了机器规模,也说明这是个单人项目。
数据集规模本身指向长期积累。56亿条视频元数据配上 45亿行创作者记录,意味着抓取、去重、增量更新的流水线已经跑了相当长时间。一个可以顺手做的算术是:视频量对创作者量的比值只有约 1.24,这要么说明覆盖了大量只发过极少量内容的一次性账号,要么说明创作者表的粒度并非「唯一作者」——无论哪种,都暗示这份数据的采集范围是「尽可能全」,而不是「精选」。
放到相关帖子的语境里看,同一批 Show HN 项目有共同模式:LLMSchema 从「coding agent 从迁移文件里猜 schema」的自身痛点出发,Paganel 从大型 schema 迁移的核对难题出发,Authrot 从自己在 Google Docs 上写小说的续写需求出发。DataShack 走的是同一条路的另一种起点:不是先有痛点,而是先有囤了很久的数据资产,再把它开放出去换取注意力和用户名单。
【怎么获客】
这个帖子的获客设计相当干净,几乎每一步都在降低摩擦、提高转化:
标题即钩子。 56亿条、「上传到 Hugging Face」、「免费开放数据库访问权限」三个要素叠在一起,同时命中了数据圈、AI 圈和增长圈的兴趣点。数字的绝对量级本身就是传播货币。
评论换凭据的名单机制。 这是整条链路里最有价值的一环。想拿凭据就必须在评论区留下痕迹,作者因此得到一份明确的、主动表达过需求的联系人清单——比任何一个「数据集浏览者」标签都精准。凭据通过私信发送,等于把一次公开发帖沉淀成了一个可反复触达的私域。
双渠道分发。 Hugging Face 数据集页面自带搜索和引用流量,是长期 SEO 资产;Reddit/HN 类社区帖子负责短期爆发。前者不需要维护就会持续被研究者、工程师搜到并引用,后者负责把第一批高意愿用户拉进私信列表。
稀缺感来自技术约束而非营销话术。 「我是自托管,请不要跑重查询」既是对滥用的预警,也顺带证明了这不是空壳——一个单人能扛住 56亿行查询的实例,比任何宣传都更有说服力。
免费是最强的前端。 没有注册墙、没有试用期、没有信用卡。对一个还在验证需求、尚未设计变现的项目来说,这是把使用门槛压到接近于零的正确选择。
【验证情况 / MRR】
MRR 层面:帖子中没有任何收费点。数据集免费下载,数据库凭据免费私信发放,没有订阅、没有按量计费、没有赞助商。这不是一个已变现的产品,而是一个带变现潜力的资产。
但这不等于没有验证。可观察的验证信号有三类:
- 公开可量的使用数据。 数据集托管在 Hugging Face 上,下载量、点赞、引用情况都是公开数字,随时间累积,是最硬的第三方验证。
- 有成本的需求表达。 想要凭据的人必须留言、等私信、自己配好客户端才能查询——这条路径上每一步都有摩擦,愿意走完的人,需求强度是真实的。
- 规模本身就是产出的证明。 56亿条视频、45亿行创作者、6.33亿行声音,说明采集链路已经稳定运行到能持续产出这个量级,而不是一次性抓了一把。
缺的是变现闭环。目前作者手里攥着三样东西:数据、查询能力、一份主动留过言的名单。这三样任何一样都能撑起收入,但帖子本身没有把它们连起来。
【对一人公司的可复制性】
可复制的部分:
- 抓取 → 存储 → 开放查询的流水线,一个人能跑。 ClickHouse 这类列式数据库正是为这种量级设计的,单机自托管即可支撑,不需要团队。
- 把已有数据开放成 Hugging Face 数据集。 边际成本几乎只是存储,换来的是持续被发现、被引用、被写进论文和项目的长期曝光。这是数据型一人公司最便宜的营销。
- 评论换凭据的名单机制。 任何有一份独家数据的项目都能照搬,而且不依赖平台功能,纯靠帖子运营。
- 「免费开放 + 自托管」的诚实人设。 在小圈子里,这种不设门槛的姿态本身就是信任背书。
难复制的部分:
- 采集的持续性。 到 56亿条这个量级,意味着要长期对抗限流、封禁、验证码和格式变更,还要处理去重和增量。这是以年计的投入,不是几周能追上的。护城河是「别人懒得重爬」,不是技术。
- 运维风险。 自托管 + 公开发凭据的组合天然脆弱。社交层面的「请不要跑重查询」不是工程约束,一旦有人跑起全表扫描或聚合,服务可能直接不可用。
- 平台合规。 元数据仍然指向具体的创作者和视频。TikTok 的服务条款、欧盟 GDPR、美国各州隐私法对「抓取的个人资料」都有约束,这部分风险不会因为「只是元数据」而消失。
对 OPC 的实际启示:数据生意的起点是「有一份别人没有、且维护成本高到别人不愿自己做」的数据。有了这个前提,变现可以是 API 订阅、按查询计费、给品牌与 MCN 做趋势报告、给研究机构做批量导出——路径很多,但必须先有一个带鉴权和配额的查询入口,否则无法收钱。
【风险与机会】
风险:
- 平台侧下架。 TikTok 若发函,Hugging Face 上的数据集和自托管实例都可能面临删除压力。免费、无合同的状态下,用户没有任何救济。
- 法律侧定性。 覆盖 45亿创作者标识意味着数据里含有大量可关联到自然人的信息。即便只是 username 和公开指标,在部分司法辖区也可能被认定为个人数据,抓取与再分发都需要法律依据。
- 技术侧失控。 凭据一旦扩散,就没有回收机制,也没有配额。单机数据库面对不受控的并发查询,是一个明确的单点故障。
- 商业侧两难。 完全免费意味着没有收入;一旦开始收费,社区会立刻追问数据来源的合法性,反噬口碑。
- 资产随时间衰减。 数据集的时效性取决于爬虫还在不在跑。一旦停止增量更新,热门声音、创作者榜单这类应用场景的价值会快速下降。
机会:
- 把查询能力产品化。 从私信发凭据,升级成带 API key、配额和计费的托管查询服务,是收益结构最清晰的一步。技术上只是把自托管搬到托管方案加上一层网关。
- 数据衍生品。 6.33亿声音记录是这份数据里最容易做出差异化的部分——TikTok 音乐趋势榜、声音生命周期曲线,对唱片、品牌、MCN 都是有预算的采购方。创作者增长榜和品类内容图谱同理。
- 开放 SQL 本身就是差异化。 市面上大多数 TikTok 数据服务只提供固定接口,给数据团队一个能自由写 SQL 的沙盒,是很强的吸引力,尤其对研究者和内部数据团队。
- 分层设计。 免费层给 Hugging Face 上的历史快照,付费层给实时增量、更高配额和自定义查询。这样免费部分继续承担获客,付费部分才承载收入,两不冲突。
- Hugging Face 的引用红利。 数据集页面的长尾流量会持续带来研究者,而研究机构与企业研究部门恰好是愿意为数据付费、又对免费样品敏感度低的客群。
信息来源:Reddit、Hugging Face、Hacker News Show HN
- 第一步:选定一个能长期爬取的公开数据源(如 TikTok 声音/BGM 榜单),用现成爬虫脚本按日增量抓取元数据并落地为 CSV/Parquet。
- 第二步:把数据导入自托管 ClickHouse 建三张表(创作者/视频/声音),按唯一 ID 去重并做增量更新。
- 第三步:把历史快照打包上传到 Hugging Face 数据集页,写好字段说明,靠其搜索与引用流量长期获客。
- 第四步:在帖子里以「评论换凭据」私信发放只读 SQL 账号,把留言者沉淀成私域名单,再逐步加 API key、配额与计费。
- 长期对抗限流、封禁、验证码与页面格式变更,维护成本以年计
- 自托管 + 公开凭据无配额,一次全表扫描即可拖垮单机实例,且凭据无法回收
- 元数据仍指向真人,TikTok 条款、GDPR 与各州隐私法对抓取和再分发有约束,平台发函可能直接下架数据集
- 完全免费无收入,一旦转向收费,社区会追问数据来源合法性,反噬口碑;停止爬虫则数据时效价值快速衰减