开源AI数据情报系统,多源数据一键洞察
【这是什么】
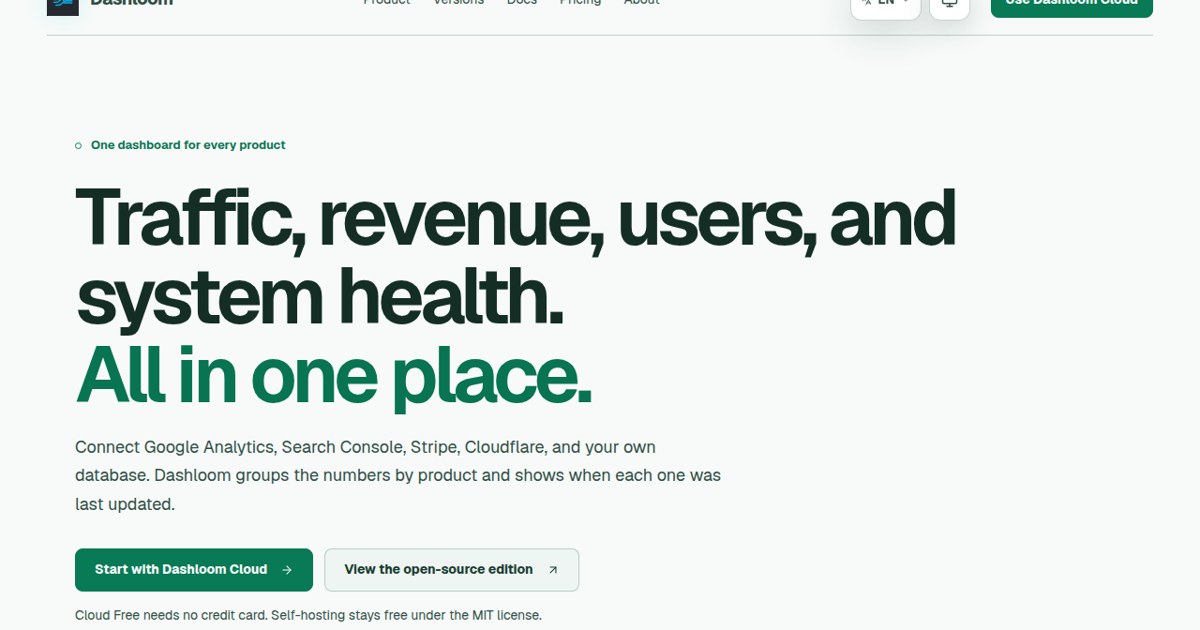
Dashloom 是一个面向独立开发者、小型 SaaS 团队和代理运营团队的 AI 情报与数据管理系统。它解决的核心痛点是:一个运营十几个甚至几十个产品的开发者,数据分散在分析工具、支付平台、代码仓库和云基础设施中,每次想整体过一遍数据需要耗费大量时间。Dashloom 将这些数据源标准化到统一的「证据层」,然后通过 Agent 进行分析——先用确定性指标和信号雷达筛出值得关注的变化,再让用户自己的 OpenAI 兼容模型生成带证据引用的洞察、行动建议和定期报告。
关键设计特征:
- 多产品数据隔离:支持多个产品分开管理,适合批量运营多个项目的个人/小团队。
- 预设 Agent 场景:独立开发者 SaaS 收入、SEO 增长、Cloudflare 运维、客户报告。
- 证据引用机制:Agent 结论必须引用实际证据,避免把相关性描述为因果关系——这是针对 AI 幻觉的明确工程决策。
- 可扩展 Skill 体系:通过安装 skill 丰富 Agent 能力。
- 完全自部署:开源版本接入自己的数据、使用自己的 API Key,无隐私泄露问题。
支持的数据源覆盖面很广:Google Analytics、Google Search Console、Bing Master(产品与增长);Stripe、Lemon Squeezy、Creem、Polar、Paddle(收入与支付,还支持导入自定义收入数据库以覆盖所有支付渠道);GitHub、Vercel(开发与部署);Cloudflare Workers/Pages/Queues/R2;Supabase、Cloudflare D1(数据库);以及 Custom REST、手动指标导入、开放摄取 API、TypeScript SDK 和 Connector Worker(自定义扩展)。支持 OAuth 的平台一键接入,其余需手动配置变量和密钥。
另有 SaaS 云版本 dashloom.dev(仍在完善中,免费试用),但开源版是当前主推形态。
【背景 / 谁做的】
帖子发布于中文社区,作者没有透露个人身份,但从内容可以判断是一位资深独立开发者/小团队负责人——痛点描述具体且真实(「每次要把所有数据整体过一次,要经历很长的时间」),典型的一人公司式问题。
技术上,作者有相当强的全栈能力:这套系统涉及多个数据源的 API 对接(OAuth、Webhook、REST)、数据标准化建模、Agent 编排(确定性指标 + 信号雷达 + AI 分析)、多租户隔离,还提供了 TypeScript SDK 和 Connector Worker——这些不是简单的脚本拼接,而是一个工程化的产品。
作者还展示了务实的产品思维:不追求 AI 全自动分析,而是「确定性指标先过滤,AI 再做深度分析」,并且要求 Agent 引用证据、不把相关性说成因果——这是和 AI 产品打交道踩过坑之后才会写进架构里的设计。
开源动机也很明确:自己用了一段时间后,发现朋友也有类似痛点,于是开源。GitHub 组织为 dashloom-dev,项目 README 提供了中英文双语版本,说明作者有意面向国际用户。
【怎么获客】
当前获客方式可以归纳为以下几种:
- 开源社区传播:在中文技术社区以「[分享创造] [开源]」标题发布帖子,这是独立开发者获取初始用户最直接的渠道。GitHub 仓库同时提供中英文 README,也在为海外开发者社区(如 Hacker News、Indie Hackers)的传播做准备。
- 免费 Cloud 版本引流:dashloom.dev 提供免费试用,作为开源版的「体验入口」。用户可以先在 Cloud 上感受产品价值,再决定是否自部署或后续付费。
- 开发者口碑(KOL 路径):目标用户群体(独立开发者、SaaS 小团队)高度集中在特定社区,这些用户本身有分享习惯,产品如果真的好用,会在独立开发者圈层内形成口碑传播。
- 数据源生态合作:产品支持 Stripe、Vercel、Cloudflare、Supabase 等热门平台的数据接入,这些平台生态内的开发者天然是潜在用户。
不过帖子发布时的产品定位侧重「自用 + 朋友用」,尚未见到系统性的增长策略。目前的增长逻辑是:开源塑造信任 → 自部署验证价值 → 口碑扩散 → 后续通过 Cloud 商业化承接流量。
【验证情况 / MRR】
帖子和公开信息中没有披露任何 MRR 数据、用户数量或付费转化数据,也没有提及 GitHub Star 数量。基于现有信息可以确认以下验证信号:
- 作者自用且打磨了较长时间:这是真实痛点驱动的项目,不是凭空造概念,「自己用了很久」是产品验证的第一层。
- 朋友有类似痛点:至少完成了从「自用」到「他用」的跨越,产品对同类人群有价值。
- 开源版本已发布:作者认为代码质量、文档完整度已经可以对外展示。
- Cloud 版本已上线(免费试用):虽然「还没完善好」,但已经可以跑通从注册到关联数据源的流程——说明作者验证了真实用户愿意尝试接入自己的数据。
整体判断:项目处于早期验证阶段,技术可行性已经验证(作者自己就在用),产品-市场匹配仍在探索中。商业模式尚未定型,Cloud 版本免费试用是商业化探索的信号,但离稳定的 MRR 还有明显距离。云版本在关联数据报错的位置需要「点击信任强制关联」——这个细节说明数据源接入的稳定性还有提升空间。
【对一人公司的可复制性】
这个项目对一人公司(OPC)的参考价值可以从两个层面看:
1. 作为产品:Dashloom 解决的是 OPC 的真实痛点
OPC 的典型特征就是「一个人管所有事」,数据分散在十几个平台是常态。Dashloom 的核心价值恰恰是把这些碎片化的数据收拢,用 AI 辅助生成可执行的洞察,节省的是 OPC 最稀缺的资源——时间。同时,OPC 往往是多产品运营的状态,Dashloom 的多产品数据隔离设计精准匹配这种结构。对于技术能力和数据源类似的 OPC,自部署 Dashloom 是低成本的效率提升方案(只花时间和精力,不花订阅费)。
2. 作为创业项目:Dashloom 的模式可复制性很强
这可能是更有价值的层面。Dashloom 展示了 OPC 可以做出的产品形态:一个作者解决了自己的问题 → 发现同类人有同样的痛 → 顺手开源 → 用 Cloud 版本探索商业化。这种「自己就是目标用户」的创业方式,试错成本低,产品方向不容易跑偏。
作者的技术栈选择也值得借鉴:数据源接入层(连接器/SDK/API)+ 标准化数据层(证据层)+ Agent 层(分析推理)+ 交付层(报告/看板/Skill),这种分层架构让 AI 应用建立在可控的数据确定性之上,而不是让 AI 直接面对混乱的原始数据。
在构建质量方面,作者实际示范了「利用 codex 或 cc code 帮自己调整功能或二次开发」——把自己开发的系统变成可让 AI 修改的代码库,这本身就是 OPC 用 AI 杠杆放大个人产能的典型案例。对想走类似路线的个人开发者来说,这个项目是一个完整的参考样本:如何设计数据接入架构、如何设计 Agent 的确定性 + 生成式混合流程、如何做多租户隔离、如何做开源与 SaaS 双轨。
另外一个容易被忽略的复制点:Dashloom 的预设场景(SaaS 收入、SEO 增长、Cloudflare 运维、客户报告)对应的是独立开发者的核心高频需求。如果产品能跑通,可以横向扩展到电商数据、广告投放、社交媒体运营等更多垂直场景,成为 OPC 的「数据 Copilot 基础设施」。
【风险与机会】
风险:
- 数据源 API 的持续维护成本:支持十几个数据源的接入,每个平台的 API 变动、OAuth 更新、速率限制都需要持续跟进维护。这是一个长期包袱,对于个人维护者来说负担不小。云版本「关联数据报错」的提示说明这方面已经出现摩擦。
- 与现有 BI/Analytics 工具的竞争:Google Analytics、Mixpanel、Metabase 等产品也在不断添加 AI 能力。Dashloom 的差异化在于「多产品统一视图 + AI 分析」,但需要持续保持技术领先才能守住位置。
- AI 分析可信度的信任门槛:虽然设计了证据引用机制,但 AI 生成的洞察和行动建议是否真正可靠,需要长期的用户信任积累。一旦出现一次明显错误分析,可能丢失用户信任。
- 商业化路径不明确:开源免费 + Cloud 付费的模式是当下主流,但 Cloud 版本尚未完善。如果 Cloud 版本体验不佳,可能反过来影响开源版本的口碑。
- 独立开发者做 toB 产品的支持压力:如果企业用户开始使用,会带来工单、SLA、定制需求等支持负担,一个人难以兼顾。
机会:
- 赛道窗口期:AI 原生数据分析工具市场还在早期,「确定性数据层 + AI 分析层」的架构设计比传统 BI 更贴合新一代用户的使用习惯。独立开发者和小型 SaaS 团队数量持续增长,这类轻量级工具正好满足他们的需求。
- 开源获客 + 云托管的成熟变现路径:Supabase、PostHog、Cal.com 等已验证了「开源 + 托管服务」模式。Dashloom 完全对齐这套玩法——开源版建立信任和技术影响力,Cloud 版提供零配置的上手体验。
- 与 AI 辅助开发趋势的共振:作者推荐的「用 codex 或 cc code 二次开发」模式,实际上是让 Dashloom 成为可被 AI 理解和修改的代码库——这是未来软件的趋势。如果项目能沉淀出好的 Skill 生态,可以形成类似插件市场的网络效应。
- 垂直数据场景扩展:预设场景目前是「SaaS 收入、SEO、Cloudflare 运维、客户报告」,但架构上是通用的:任何有「多个分散数据源 + 需要统一分析」的场景都可以用,比如跨境电商、内容创作、广告投放。每一类垂直场景都是一个可以切入的市场。
- 个人开发者品牌资产:即使 Dashloom 本身没有做成大生意,这个开源项目本身会成为作者的技术品牌证明,在独立开发者社区的影响力可以转化为其他项目的获客优势、合作机会或职业机会。
信息来源:V2EX、GitHub
- 第一步:用现成 OAuth/REST 客户端先只接 1-2 个核心数据源(如 Stripe 收入 + Google Search Console 流量),跑通单个产品的数据拉取与刷新。
- 第二步:把拉到的原始数据标准化写入统一「证据层」表结构,直接复用 Supabase 或 Cloudflare D1 这类现成数据库,不做自研存储。
- 第三步:接入自己的 OpenAI 兼容 API Key,实现「先确定性指标 + 信号雷达筛选、再交模型生成带证据引用的洞察」的混合流程,避免让模型直接面对原始数据。
- 第四步:用开源看板/报告模板做交付层页面,把分析逻辑封装成可安装的 Skill,以中英双语 README 开源发布到独立开发者社区收集反馈。
- 数据源维护是长期包袱:十几个平台的 API 变动、OAuth 更新、速率限制都要持续跟进,云版本已出现「关联数据报错、需点击信任强制关联」的摩擦,说明接入稳定性尚未过关。
- 信任风险单向不可逆:一旦 AI 生成一次明显错误的洞察或把相关性说成因果,即便有证据引用机制,也可能直接丢失用户信任。
- 商业化路径未定型:Cloud 版尚未完善,如果试用体验不佳,可能反过来拖累开源版口碑,而开源免费 + 云托管的变现距离稳定收入尚有明显距离。
- toB 支持负担与一人产能冲突:企业用户进来后会带来工单、SLA、定制需求,超出个人维护者的承载能力;同时要面对 GA、Mixpanel、Metabase 等已内置 AI 能力的 BI 工具竞争。