一套代码双端跑:开源大模型接口测试工具
ModelApiTester 深度拆解:一人公司的大模型 API 测试工具能否破圈?
【这是什么】
ModelApiTester 是一款面向 AI 开发者的大模型 API 测试与性能对比工具。它不是一个聊天 UI,而是更接近“API 调试台 + 模型性能仪表盘”的复合体:
- 协议兼容:支持 OpenAI、Anthropic、Gemini 三种主流 API 格式,并自动适配;
- 流式输出与渲染:支持 token 流式返回,完成后用 Markdown 渲染,公式和视频也能展示;
- 性能指标:每次回复展示 prefill 耗时、decode 耗时、生成速度(tok/s)、总 token 数,方便横向对比模型;
- 多模态能力:支持图片上传和文件附件;
- 内置测试套件:32 条预设提示词,覆盖推理、代码、数学、指令遵循、创意写作、多语言、常识、安全 8 个维度,一键填入输入框,省去手工设计 prompt 的成本;
- 持久化:会话和配置存 SQLite,刷新不丢失。
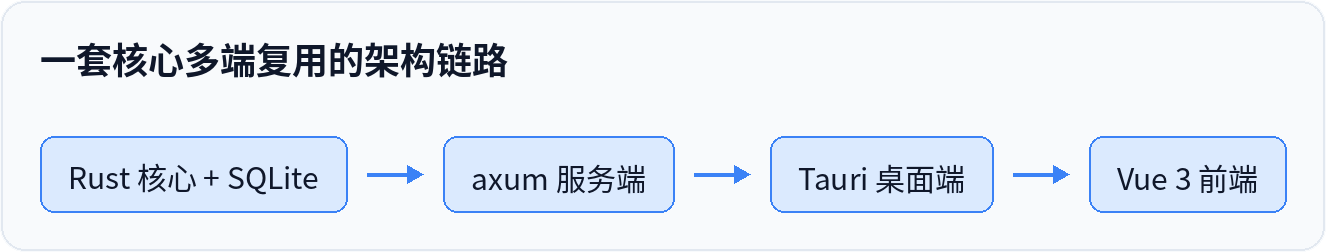
架构上非常克制:Rust 写共享核心(业务逻辑 + SQLite),上层接两个壳——axum HTTP 服务器和 Tauri 桌面应用,前端统一用 Vue 3。因此一套代码三种用法:
- 服务器部署:编译成单二进制 + 前端静态文件,直接
./mat-server运行; - 桌面应用:Tauri 打包成单文件,双击即用,数据存
~/.mat-desktop/; - 源码编译:本地开发热更新。
这本质上是把“测试工具”做成了“多端交付”的模板,核心逻辑只维护一份。
【背景 / 谁做的】
作者是 GitHub 用户 yachen4ever。从帖子内容看,他是在自己的 M2 Mac 上折腾 Qwen 系列模型时,发现需要反复调 API、看 token 速度,但圈内没有顺手的小工具——主流聊天 UI 太重,Postman 又太通用。于是按照自己的流程“vibe”了一个,顺手能当 apikey 存储器。
这是一个非常典型的“为自己做工具”的独立开发者叙事。技术选型上,Rust + Vue 3 + Tauri 的组合在相关帖子中反复出现:例如 Show HN 上的 Lap(本地优先 AI 照片管理器)和 Kide(Rust/Tauri/Vue3 的 Kubernetes IDE),都是同栈产物。这说明这套技术栈在一人公司圈子里已经形成了某种方法论——Rust 保证底层性能和跨平台一致性,Tauri 替代 Electron 减重,Vue 负责快速迭代 UI。
【怎么获客】
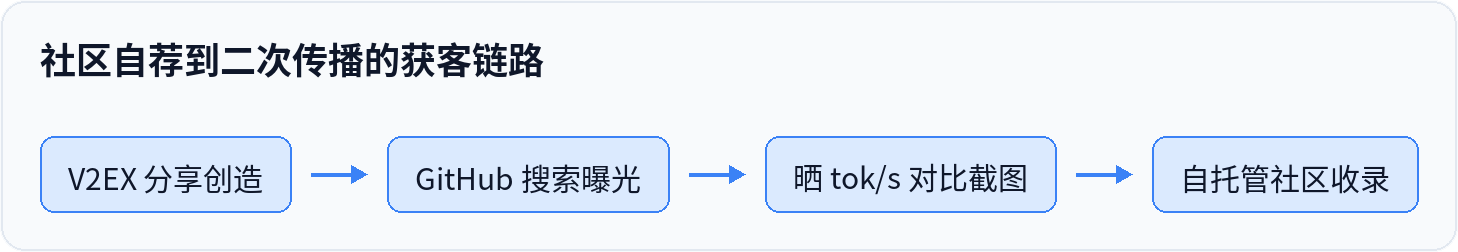
从标题和摘要看,目前获客主要靠社区自荐 + 开源曝光:
- 发布在 V2EX 的「分享创造」节点,这是一个高质量中文开发者社区,目标用户精准(会翻帖子的人大概率自己也在玩模型);
- GitHub 仓库天然承接搜索流量,尤其是像“LLM API 测试”“tok/s 对比”这类关键词,容易吸引到有同样痛点的开发者;
- 产品本身自带传播点:性能对比(tok/s、prefill/decode 耗时)很适合截图分享。一旦有人晒出“Qwen vs Llama vs GPT 的实测数据”,就会形成二次传播;
- 支持服务器部署又让它有「自托管」属性,理论上可以被 r/selfhosted、r/LocalLLaMA 这类社区收录,进一步扩大触达。
目前没有看出任何付费广告或营销活动,完全依赖口碑和 SEO 的自然流量。
【验证情况 / MRR】
截至当前信息,ModelApiTester 没有公开的 MRR 或任何收入数据,也没有明确的商业计划。项目是开源且免费的,作者在帖子中也没有挂赞助链接或云服务。
可以判断它处于早期验证阶段——验证的是“是否有更多人有同样的痛点”以及“这个工具是否值得持续维护”。虽然没有具体数字,但从技术完成度看,作者至少已经投入了相当时间(预设提示词、多端架构、SQLite 持久化这些不是一天能写完的),说明作者自己作为用户是真的需要它。
同类产品的市场表现可以从相关帖子侧面感受:同为 Tauri 开发的 MarkerOn(1.5MB 截图工具)和 LumaBoards(离线看板)都在 Show HN 上获得了讨论,说明用户对轻量本地工具的需求真实存在。但 API 测试工具这个细分领域更垂直,验证周期可能更长。
【对一人公司的可复制性】
ModelApiTester 最大的可复制价值不在于这个工具本身,而在于它展示了一套适合一人公司的产品工程范式:
-
一套核心,多端复用
Rust core + SQLite + 两套薄壳(axum / Tauri)+ 一套 Vue 前端。新增功能只需改核心逻辑,三个端同步生效。对一个人来说,这几乎是最优维护成本的结构。 -
精准切入“测试”而非“生产”
AI 开发者不缺聊天 UI,缺的是能快速横向对比、量化结果的工具。测试工具可以不做成平台,而是做成一个“够好使的小玩意”,降低用户替换成本。 -
用开源换取信任
API 测试工具需要让用户放心输入 apikey。开源 + 本地存储(SQLite / ~/.mat-desktop/)直接消解隐私疑虑,这是闭源小工具很难做到的。 -
后续商业化路径清晰
- 托管版:把服务端做成云服务,多人协作共享 apikey 和评测结果;
- 付费功能:团队协作、报告导出、历史数据趋势分析;
- 数据资产:把用户匿名化的模型跑分做成公开排行榜,靠流量连接模型服务商。
【风险与机会】
风险
- 竞争者众多且免费:OpenAI 官方 Playground、Anthropic 控制台、Ollama、LangSmith、以及各类 open-source benchmark 脚本已经覆盖了大部分功能。如果没有差异化的“性能对比”心智,很容易被替代。
- API 格式漂移:OpenAI、Anthropic、Gemini 的协议会不断演进,单维护者需要持续跟进更新,否则兼容性会像“漏水的水桶”。
- 商业化天花板:开发者工具付费意愿弱,尤其是这种“自己也能写”的 CLI 级产品。若不能迅速积累用户,容易沦为数字花园。
- 单人维护风险:作者一旦失去兴趣或被其他项目占用,项目就会停止维护,用户信任受挫。
机会
- 多模型时代刚需:本地模型(Qwen、Llama)和云端 API 混用会是常态,跑分、选型、调参都需要一个轻量工具。ModelApiTester 有潜力成为“AI 评测界的 switch”。
- 性能对比是硬信息差:tok/s、prefill/decode 耗时这些指标直接关系到成本和服务选型,如果作者做出一个公开的“多模型性能数据库”,价值会叠加。
- 自托管 + 隐私卖给企业:企业想在内部评测大模型,又不想用外部 SaaS,一个能部署在内网的单二进制工具刚好命中需求。这比个人开发者更有付费意愿。
- Tauri 生态红利:相关帖子里已经有多个成功的 Tauri 独立产品,证明用户能接受这种轻量桌面应用。ModelApiTester 还可以顺势接更多本地模型(如 Ollama)作为测试源,扩大覆盖面。
信息来源:V2EX、GitHub
- 第一步:用 Rust 写一份共享核心(请求构造、流式解析、token 计时、SQLite 持久化),用 sqlx/rusqlite 存会话与 API 配置,保证后续服务器端和桌面端共用同一份逻辑。
- 第二步:用 axum 起一个 HTTP 服务端壳,编译成单二进制 + Vue 3 静态文件,本地 `./mat-server` 即可跑通 OpenAI / Anthropic / Gemini 三种协议的路由适配层。
- 第三步:用 Tauri 把同一个 Rust core 再包一层桌面壳,Vue 3 前端复用同一套界面,数据落到 ~/.mat-desktop/,实现双击即用。
- 第四步:把 32 条预设提示词按推理/代码/数学等 8 个维度做成 JSON 配置一键填入,并在响应区渲染 prefill 耗时、decode 耗时、tok/s 与总 token 数做横向对比。
- OpenAI / Anthropic / Gemini 三家协议持续演进,单人维护要长期跟进,否则兼容性会变成漏水的水桶。
- 竞争者全是免费且背靠大厂:OpenAI Playground、Anthropic 控制台、Ollama、LangSmith 及各类开源 benchmark 脚本,缺少「性能对比」心智很容易被替代。
- 开发者工具付费意愿弱,且目标用户「自己也能写」CLI 级替代品,商业化天花板低,容易沦为无人维护的数字花园。
- 工具要用户交出真实 apikey,任何一次协议适配失误或密钥存储事故都会直接摧毁信任,必须靠开源 + 本地 SQLite 存储来兜底。